长往往来自通用模板与模糊输入的叠加——看清生成路径,才能治好这份文档。
五十页的"完美"文档,为什么没人能照着干活?
把一句话需求丢给 AI,让它写份 PRD。三十秒后,一份五十多页的文档摆在你面前:背景目标、竞品分析、用户画像、信息架构、功能清单、字段说明、埋点设计、风险预案、附录术语表——格式工整,措辞专业,每个章节都像模像样。
你把它转给开发。十分钟后,开发回了三个问题:所以这个功能到底先做哪几个字段?这张表跟我们现在用的是不是重复了?"优先级调度引擎"是什么,谁提的?
这份文档很长,也很专业,但没有人能照它干活。这就是很多团队正在经历的场景:AI 生成的 PRD,又臭又长。
骂模型没有用。要治这份文档,得先把它拆开,看清"长"从哪来、"臭"在哪、AI 为什么会这样——以及,我们自己在这件事里扮演了什么角色。
一、"长"从哪来:完整性的表演
先看"长"的部分。AI 生成的 PRD 之所以长,通常不是需求复杂,而是三种膨胀:
- 模板膨胀:你在提示词里给了旧模板,或者它套用了通用的"标准 PRD 模板",于是背景、竞品、画像一个不少——哪怕这个需求只是加一个导出按钮。
- 细节膨胀:每个功能点都被展开成完整的三段式(描述、规则、异常处理),大量"正常情况下""如无特殊说明"式的填充句,用详细感撑起篇幅。
- 边界膨胀:顺手把"未来可扩展""二期可考虑"的内容写进正文,需求边界从一页悄悄扩散到十章。
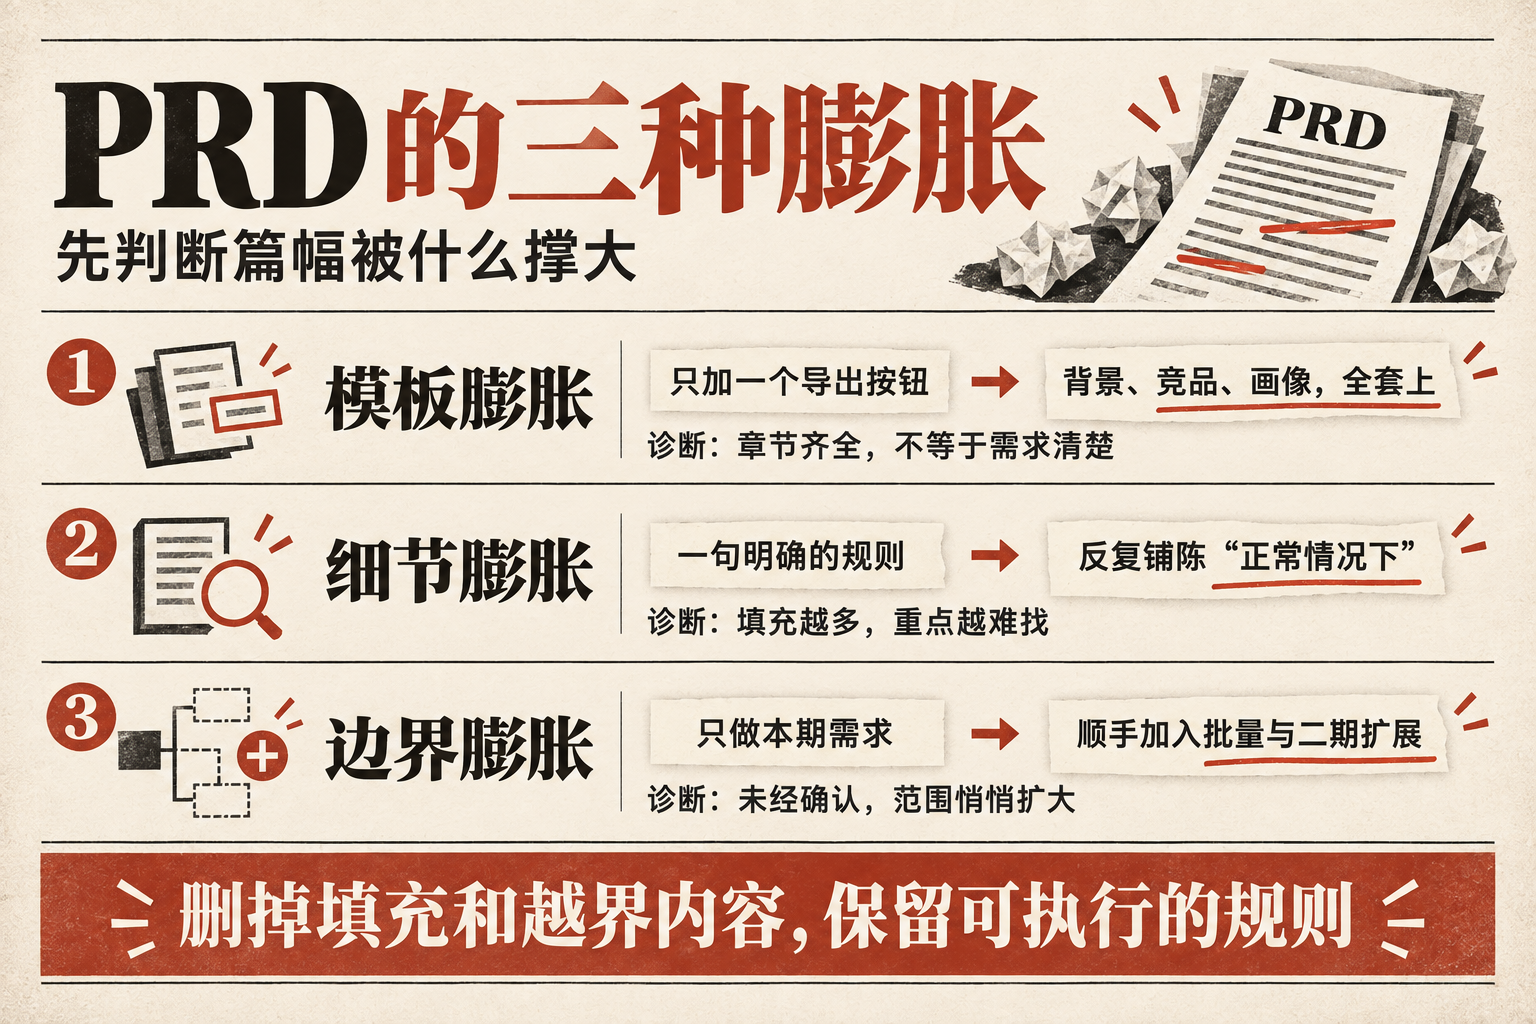
图 1:先判断篇幅被什么撑大,再决定删什么。文中配图均可点击查看原图。
这些膨胀有一个共同的名字:完整性的表演。AI 在用"覆盖了所有章节"来证明自己专业,就像一个新来的实习生,用最厚的周报证明自己没偷懒。
随手翻一页,就能看到这种表演的痕迹。比如 AI 写的一条字段说明:
该字段默认为空;如无特殊说明,用户不可自行修改;特殊情况下可由管理员手动配置;未来二期可考虑扩展为支持批量操作。
可以先压缩成:默认空;用户不可修改;管理员配置条件待确认。至于批量操作,未确认前应移出本期范围。删的是填充与越界设计,不能把尚未明确的"特殊情况"顺手改成已确定的规则。
问题在于,长文档的代价早就变了。过去文档稀缺,写得全是本事;现在扩写很容易,读者——开发、测试、以及下一个接手的 AI Agent——的注意力才是稀缺资源。没人看的内容不是零成本,是负成本:它在稀释真正重要的信息。
二、"臭"在哪:过度设计的字段与自造的实体
"长"只是浪费注意力,"臭"才会真的出事故。而 AI 最典型的问题,恰恰集中在文档里看起来最专业的那部分:功能规则与字段定义。
一个场景。让 AI 设计"定时发布"功能,它给你造出一张定时任务表:优先级、重试策略、时区偏移、审计日志、操作人快照……看起来非常专业。但你的系统里已经有一半字段,剩下那一半,没有任何场景会消费它们。
这就是 AI 最隐蔽的一类毛病——过度设计,具体有四种面目:
- 冗余字段:系统里已有的字段,它再设计一遍,还换了个名字。
- 自造实体:凭空发明你的系统里不存在的对象,让开发多建一张表、多写一套接口。
- 过度抽象:把一个简单功能包装成"引擎""中台""框架",四两的需求扛千斤的架构。
- 规范冲突:字段命名、枚举定义和你项目的既有约定对不上,开发要么改文档,要么改习惯。
过度设计之外,还有一种更隐蔽的臭:自信的编造。它会用同样专业的口吻,写出你系统里根本不存在的枚举值、从未支持的默认行为——错得工整,错得笃定。这也是后面"边界审查"那一问必须存在的原因。
冗余设计如果在评审时被放过,就会在开发落地时暴露成本:字段对不上现有表结构、多写迁移脚本、多背维护逻辑。看似只是文档里多了几行,排期时却可能多出一串任务。
拿"定时发布"做一次简化审查,重点是判断依据,不是把所有新增项都删掉:
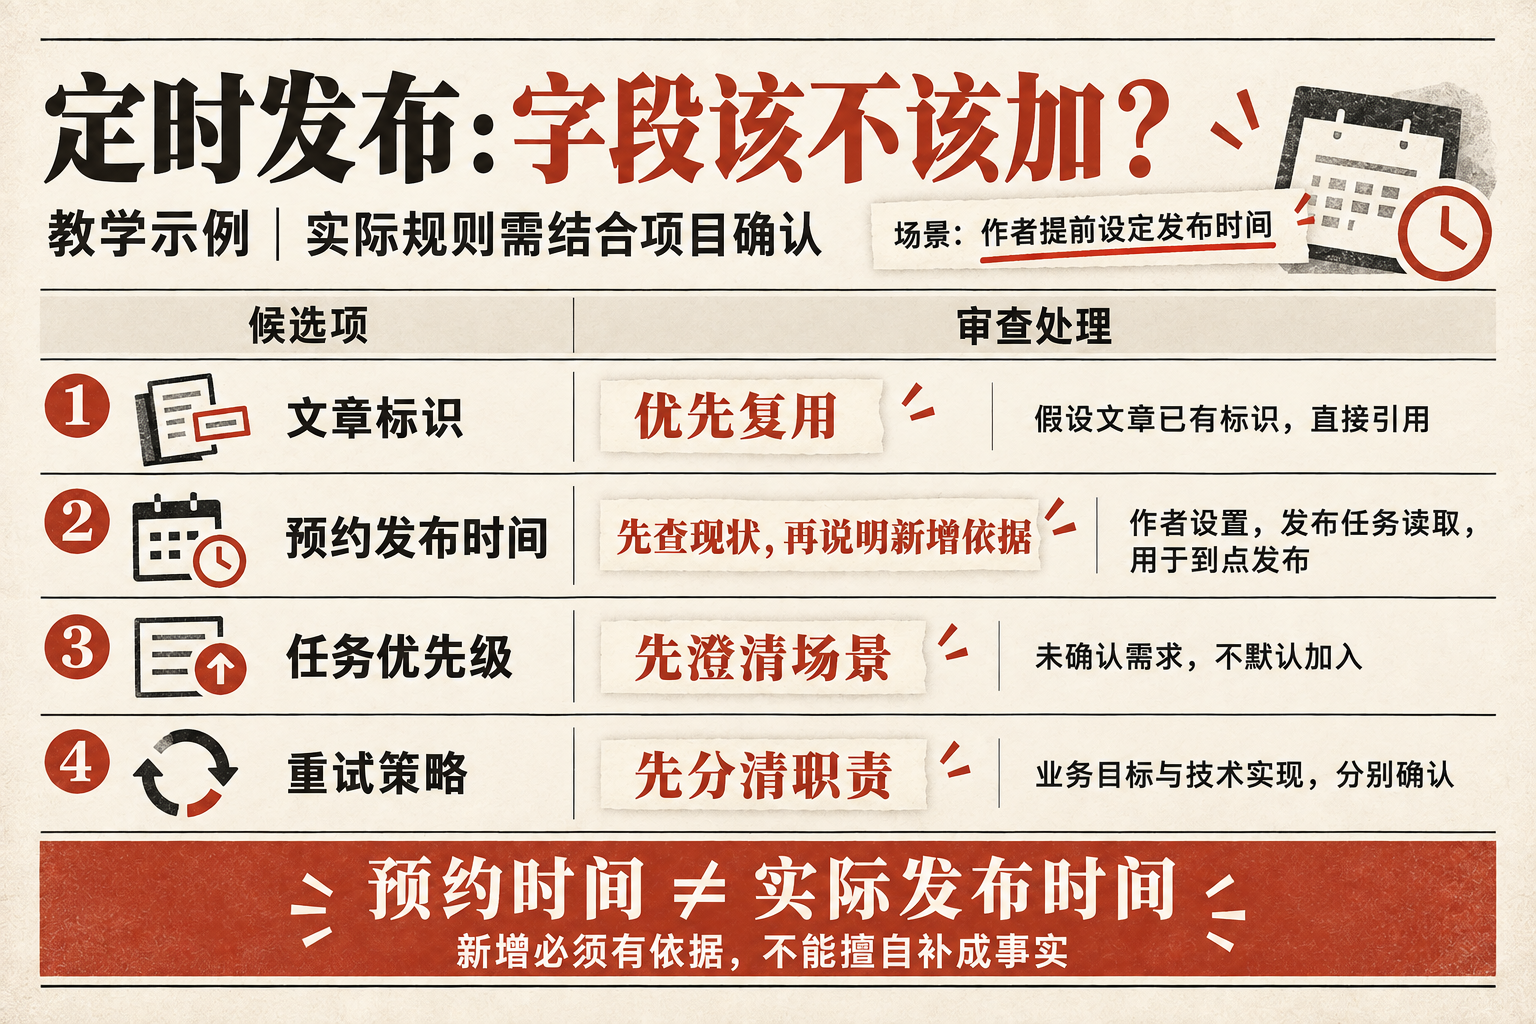
图 2:虚构教学示例,假设系统已有文章标识。实际字段归属与规则需对照项目现状确认;预约时间也不能直接等同于实际发布时间。
三、AI 为什么会这样:四个常见诱因
要治它,先要理解它。面对一份膨胀的 PRD,可以从四个方向排查;它们是实用的诊断线索,不是对所有模型内部机制的定论:
- 通用模板惯性:没有项目范例和篇幅边界时,生成结果容易沿用通用章节。模板覆盖得广,不代表每一项都适合这次需求。
- 上下文缺失:它看不到你现有的数据库表、代码实体和命名习惯。不知道系统里已有什么,就可能凭通用经验补出一套新的设计,错过复用机会。
- 目标含糊:只要求"完整、专业、详细",却没说明哪些决策才重要、哪些内容不该写,输出就容易朝着扩写走。
- 成本反馈缺席:生成一条字段建议很容易,开发却可能为它写迁移、改接口、长期维护。没有把这些约束写进输入或带回评审,建议就缺少成本校准。
这四个方向,都能通过补充上下文、调整模板和设置评审规则来改善——这就是下一节的内容。
四、另一半责任在人:你喂它什么,它就表演什么
说句公道话:这些问题既与模型表现有关,也与我们怎么提要求有关。
最常见的喂法有两种。第一种,把团队沿用多年的旧 PRD 模板直接丢给 AI——等于让 AI 往一张五十页的表格里填空。没有说明哪些章节可以跳过,它就容易逐项展开。模板要求越多,输出越容易跟着膨胀。
第二种,提示词只写"帮我写一份完整的 PRD"。没有进一步界定"完整",它就可能按覆盖章节来组织答案,再附赠三个"二期可扩展"。
所以诊断的结论是:AI 的 PRD 又臭又长,不是单纯的模型问题,而是通用生成倾向 + 松散输入 + 缺少审核共同作用的系统问题。系统问题,要用系统方法治。
五、怎么治:审核四问,防范四招
治法分两层:一份文档生成之后怎么审,以及,怎么让它以后不再犯。
审核四问,对每份 AI 生成的字段定义过一遍:
- 对照现有实体查重:新设计里的每个实体和字段,先问"系统里是否已有承载它的地方"。有,就先评估能否复用。
- 字段溯源三连:谁写入?谁读取?在哪个场景使用?三个问题答不上来的字段,就是嫌疑犯。
- 边界审查:枚举是否闭合、默认值是否合理、是否可空、是否唯一。这一层错误最隐蔽,也最容易带到线上。
- 成本视角复核:拿着 AI 的设计跟开发过一遍——哪些字段要写迁移、哪些要改接口。真实成本浮出水面,冗余自然现形。
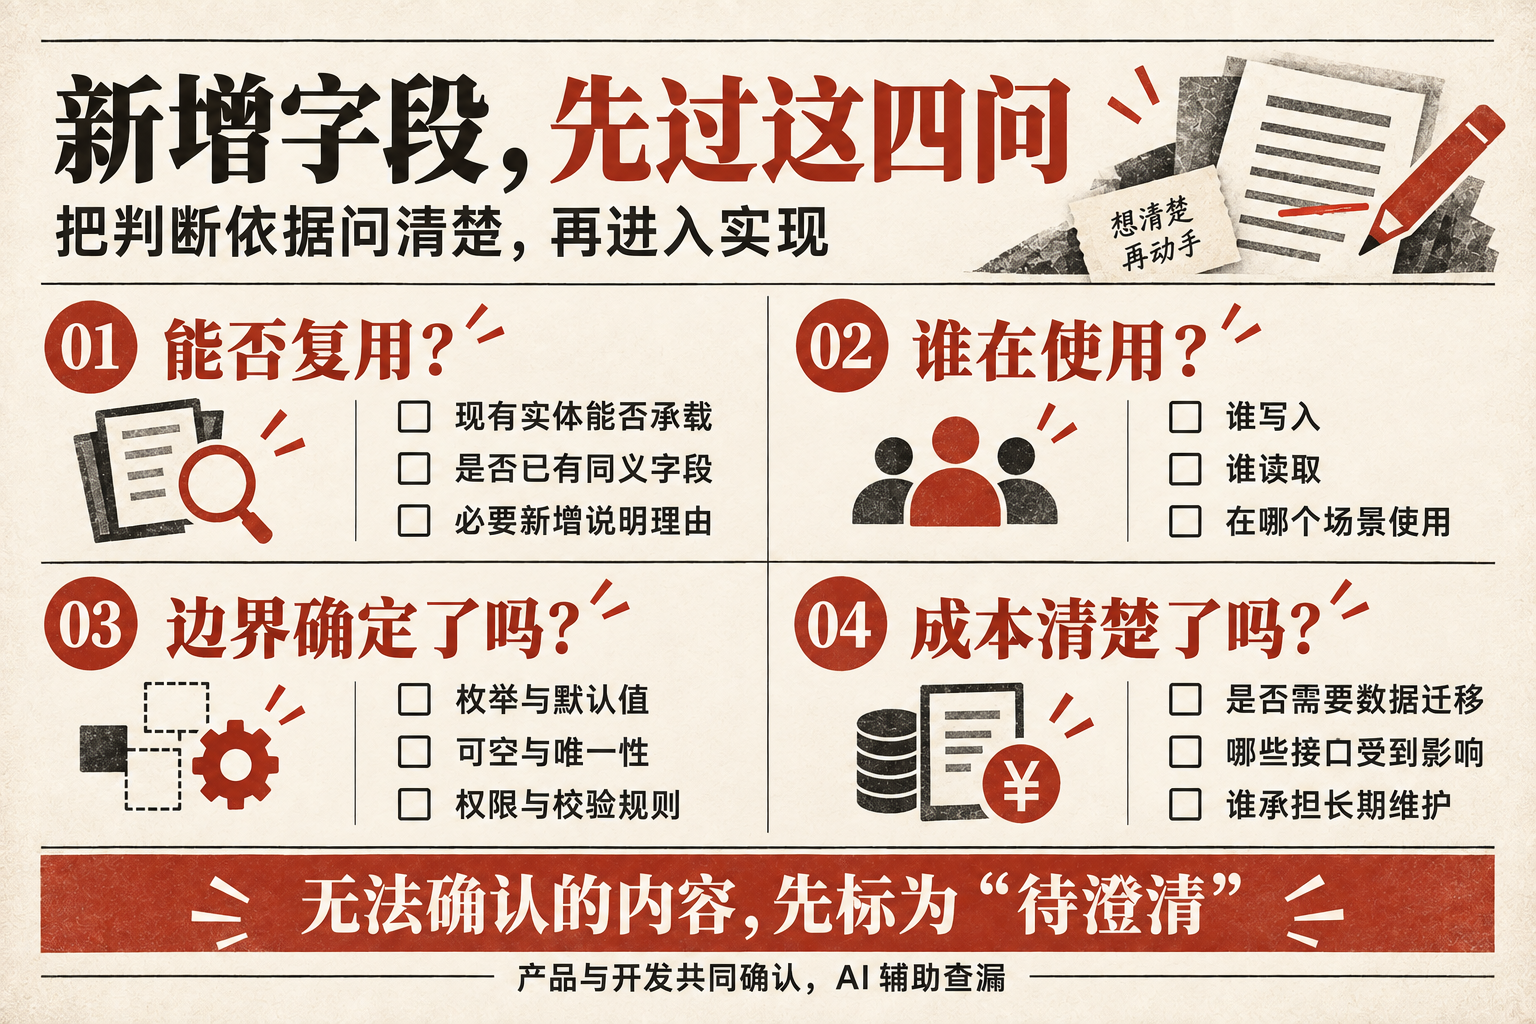
图 3:把问题问到能作出决定;无法确认的内容先标为待澄清。
防范四招,让 AI 下一次生成时就走对路:
- 把现状喂进上下文:生成字段定义前,把现有的数据模型、表结构、命名规范作为输入给 AI,并确立一条显式原则——复用优先,新增必须说明理由和使用场景。
- 写清生成规则:在提示词或团队的规则文件里明确约束,例如"不得擅自重复建设现有实体""每个新增字段必须标注写入方、读取方、使用场景"。必要的新实体仍可提出,但必须说明理由并经过确认。
- 用审核通过的 PRD 做范例:把你人工审过、确认没问题的字段设计作为示例喂回去。相较于只写"要专业",具体范例能更清楚地传达团队的取舍标准。
- 沉淀审核清单为团队资产:把上面的四问固化成 checklist 文件,人和 AI 共用——新人接手流程时审核标准不丢,Agent 执行时有据可依。
第二条性价比最高,值得展开一句。你的生成规则可以短到只有三行:
- 字段设计必须优先复用上文给出的现有表结构,新增需说明理由。
- 每个新增字段标注:写入方、读取方、使用场景。
- 不得擅自引入新实体或二期设计;必要新增标注理由与待确认项。
三行规则,先为生成划出边界。规则不怕短,怕的是没有。
**审核 AI 的字段设计,本质上是在审核你对自己系统边界的理解。**审不动,说明要补的不是提示词,是对系统的认知。
换一把尺子:长短不量工作量,量共识密度
回到标题的问题:为什么 AI 生成的 PRD 又臭又长?一个常见原因是,生成和评审都把"覆盖完整"当成了质量——而我们喂给它的输入,常常还在强化这种标准。
判断一份 PRD 好不好,尺子早该换了:**文档的长短不再体现工作量,而是体现共识的密度。**开发看完不用回来问你,AI 读完不会跑偏执行,这才是好文档的标准;篇幅,只是这个标准达成之后的自然结果。
下次审你手头那份 AI 生成的 PRD,可以先问自己三个问题:
- 删掉哪一半篇幅,开发照样能开工?
- 每个字段,你说得出谁写入、谁读取、在哪里使用吗?
- 你的提示词里,有没有一条"新增必须说明理由"?
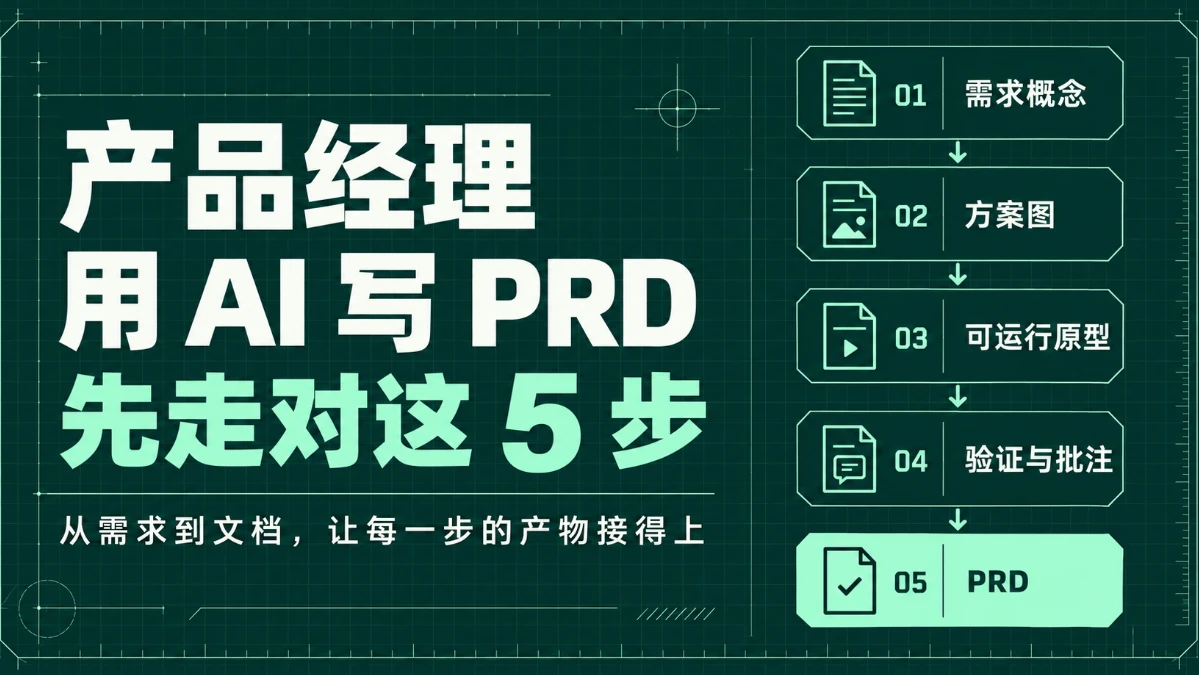
至于怎么让 PRD 从源头就短而准——概念文档怎么写、方案图怎么辅助对齐、原型怎么两条路线落地——可以接着看:《产品经理怎么用 AI 写 PRD:一条从需求到文档的五步工作流》。
评论
还没有评论
来抢沙发,写下第一条评论吧。